Stage de recherche, AIST, Tsukuba, Japon. D’avril à août 2026.
Création d’un jeu de données de navigation à 360° avec le 3D Gaussian Splatting
Quatre mois de recherche, d’un planificateur A* et de panoramas à six vues en simulation jusqu’à ArtiFixer-360, un pipeline qui transforme une simple vidéo pinhole en vidéo 360°, présenté avec l’essai qui a satisfait ses critères d’acceptation et celui qui ne les a pas satisfaits.
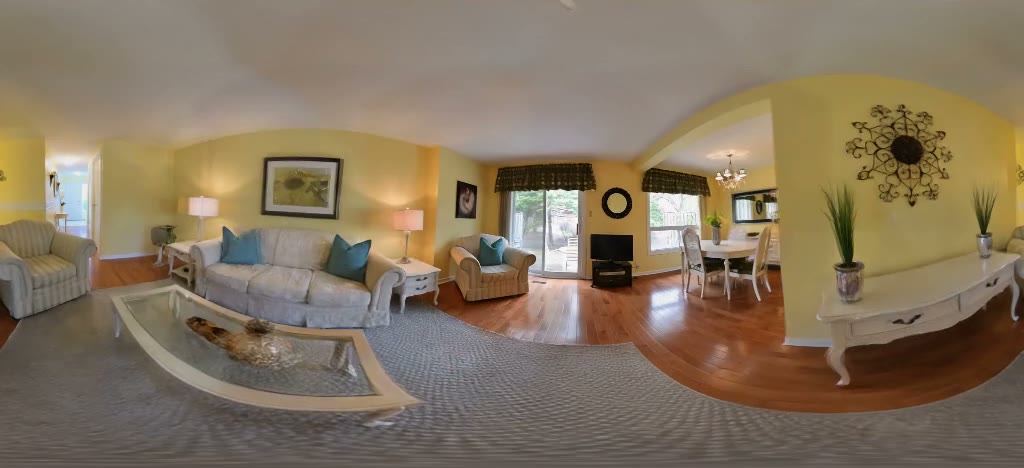 Après le premier passage d’ArtiFixer3D+
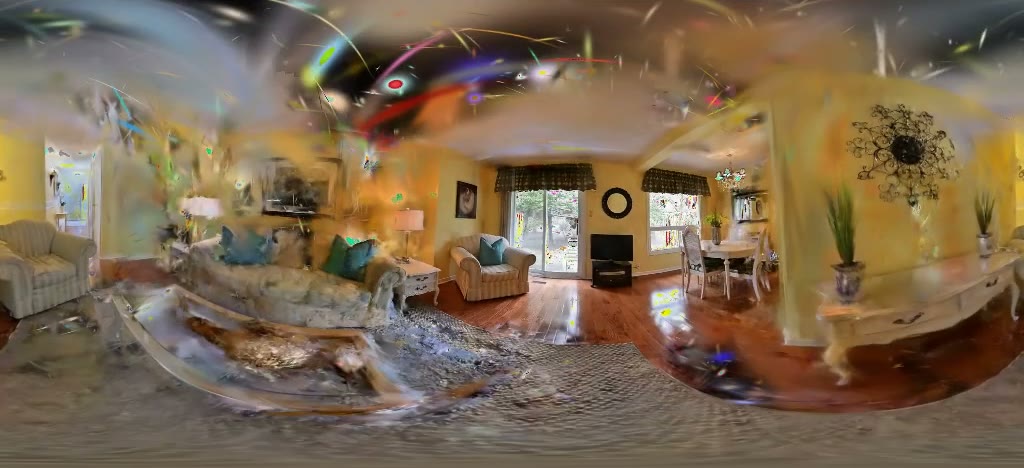 Rendu 3DGRUT brut
En trois lignes
- Problème
- Un modèle de navigation visuelle a besoin d’observations à 360° avec poses et commandes. Une scène reconstruite à partir d’une simple vidéo ne contient que ce que la caméra a vu : environ 12 % de la sphère par pose.
- Ce que j’ai réalisé
- Une simulation qui planifie, conduit et rend des panoramas de 4096 × 2048 dans une scène de gaussiennes 3D ; une interface ROS 2 préparée pour le robot Kachaka ; et ArtiFixer-360, qui répare conjointement 14 vues qui se recouvrent avec un modèle de diffusion vidéo, puis les redistille dans la scène 3D.
- Résultat
- La synchronisation tenant compte de la profondeur a réduit l’erreur de profondeur entre vues de 27 % avant la distillation, et un essai de référence de 117 images a satisfait ses critères d’acceptation. L’essai complet de 154 images, lui, ne les a pas satisfaits, ce qui a mené à une refonte qui part de la géométrie.
Contexte
D’avril à août 2026, en quatrième année, j’étais stagiaire de recherche dans la Computer Vision Research Team de l’Artificial Intelligence Research Center (AIRC) de l’AIST, à Tsukuba, au Japon. Le stage s’est déroulé en anglais et se termine par un rapport de 29 pages.
L’objectif : produire des observations équirectangulaires (ERP) à 360°, avec poses et commandes, pour la navigation visuelle de robots, à partir de scènes représentées en 3D Gaussian Splatting (3DGS).
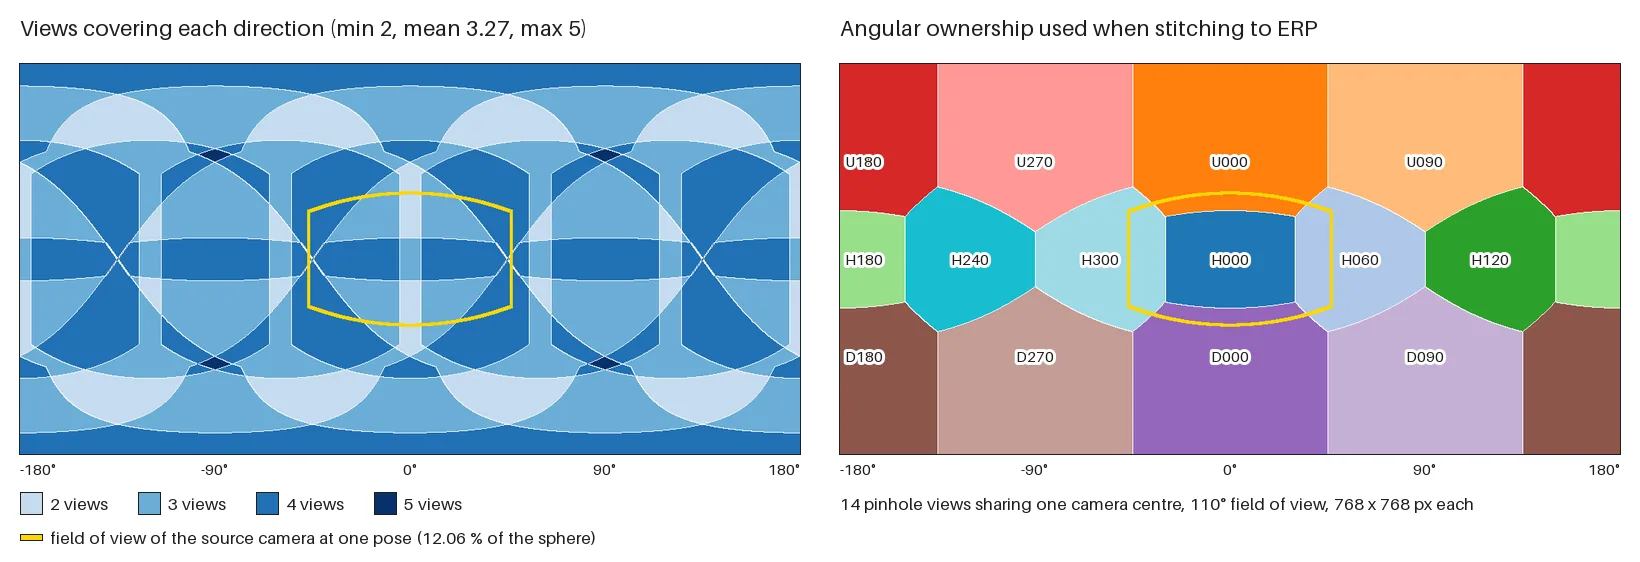
La difficulté, c’est la couverture. ArtiFixer, le modèle de réparation, a été entraîné sur de la vidéo pinhole. Un panorama demande la sphère entière, alors que la caméra source utilisée pendant le développement n’en voit que 12,06 % à une pose (un champ de vision de 93,72° × 60,93°). Tout le reste doit être rendu à partir de gaussiennes qui n’ont jamais été observées depuis cet endroit.
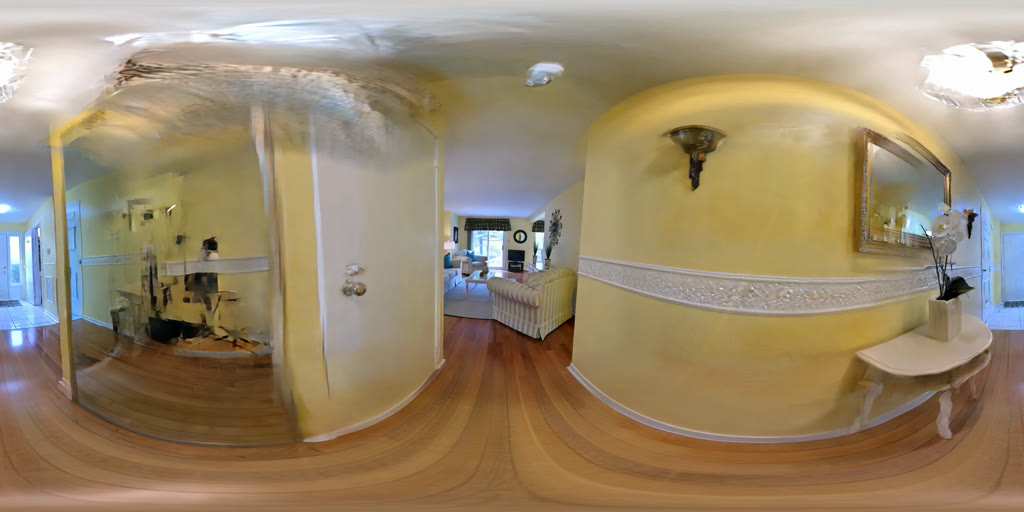
Ce que j’ai réalisé
Phase 1, mai
Navigation et rendu panoramique dans une scène 3DGS fournie
Une simulation DISCOVERSE et MuJoCo : une grille d’occupation à 5 cm, de la planification A* et du suivi de points de passage. À chaque point de passage, six vues pinhole co-localisées sont reprojetées en un panorama équirectangulaire de 4096 × 2048, avec une cubemap personnalisée à faces qui se recouvrent (faces de 96°) et un fondu progressif (feathering). Chaque panorama est enregistré avec sa position et son cap ; les commandes de vitesse sont enregistrées par le script de navigation, qui ne rend aucun panorama.
Simulation uniquement : la pose est la vérité terrain du simulateur, la base est déplacée de façon cinématique et la scène était fournie sous forme de fichier .ply. Aucun entraînement 3DGS n’a lieu dans ce dépôt.
Dépôt : nav_3dgs_panoenviron 4 000 lignes de Python, seul auteur
Phase 2, mai
Construire la scène à partir d’une simple vidéo
Une base de référence COLMAP et Splatfacto, mesurée sur une répartition 70/30 à un PSNR de 26,08 dB et un SSIM de 0,91 après 30 000 itérations, puis 28,69 dB et 0,94 après 60 000.
Phase 3, juin
Reconstruction contre génération de monde, et une interface robot
J’ai comparé Matrix-3D, HY-World 2.0 et ExploreGS avec des critères orientés navigation : couverture à 360°, rayon utile et MEt3R p90. En parallèle, j’ai préparé une interface de déploiement ROS 2 Humble pour un modèle de navigation visuelle (NoMaD) sur le robot mobile Kachaka : quatre nœuds (relais d’image, modèle, émetteur de commandes, exécuteur robot), rejet des images périmées à 0,5 s, une limitation de vitesse à 0,2 m/s et 0,5 rad/s, une surveillance « homme mort » à 20 Hz (dead-man timer), un mode à blanc (dry-run) et une surcouche typée (wrapper) autour de kachaka-api (gRPC).
Sur main, l’inférence de NoMaD n’est pas branchée, et aucun essai de navigation complet sur le vrai Kachaka n’est revendiqué.
Dépôt : KachakaNavigationenviron 3 600 lignes plus les tests
Phase 4, juillet
Réparer des rendus incomplets
J’ai appliqué NVIDIA ArtiFixer, un modèle de diffusion vidéo, à des panoramas et diagnostiqué pourquoi ils se cassent : la caméra source voit environ 12 % de la sphère par pose, et réparer les faces du cube indépendamment a fait passer le taux d’échec des coutures de 0,34 à 0,83.
Phase 5, août
Le pipeline ArtiFixer-360
Vidéo pinhole, COLMAP, une scène de gaussiennes 3DGRUT, puis un rig ancré dans le monde de 14 vues de 110° qui se recouvrent et suit la trajectoire réelle de la caméra. Les 14 flux sont réparés ensemble par le modèle de diffusion vidéo 14B, synchronisés pendant le débruitage par un graphe de reprojection qui tient compte de la profondeur et des occlusions, redistillés dans la scène 3D avec la géométrie verrouillée, puis rendus en vidéo équirectangulaire à 360°.
Un dérivé de nv-tlabs/ArtiFixer de NVIDIA, sous licence Apache-2.0.
Dépôt : artifixer-360-pipelinemon delta par rapport à l’amont : +23 602 / −630 lignes, 121 nouveaux fichiers
ArtiFixer-360, d’une simple vidéo à une vidéo 360°
- 01Vidéo pinhole
- 02Poses COLMAP
- 03Scène de gaussiennes 3D partagée3DGRUT
Rendre, réparer, distiller : les vues réparées retournent dans la scène partagée
- 04Rig ancré dans le monde14 vues, champ de vision de 110°, centres de caméra réels
- 05Réparation conjointe14 flux, fenêtres de 77 images, synchronisés par un graphe de reprojection qui tient compte de la profondeur et des occlusions
- 06Distillation à géométrie verrouilléede retour dans la scène 3D
- 07Assemblage frustum vers ERPdes rendus finaux
- 08Vidéo ERP à 360°
- 09Critères d’acceptation sans référencedécident si un essai est publié
14
vues de 110° qui se recouvrent par pose : six sur l’horizon, quatre inclinées de 45° vers le haut et quatre vers le bas. Elles partagent le centre de la caméra réelle, donc deux vues diffèrent d’une rotation pure.
Ce qu’il y a autour du modèle
Mon delta par rapport au code NVIDIA amont est de +23 602 / −630 lignes sur 145 fichiers (121 nouveaux, 24 modifiés), dont 32 nouveaux modules de test (119 tests). Il couvre les générateurs de trajectoire et de rig, la boucle d’inférence multi-vues conjointe, les réglages de distillation, l’assembleur frustum vers panorama, et des tâches PBS et Singularity pour les nœuds à 4 GPU du cluster ABCI. Un patch complémentaire pour 3DGRUT-ArtiFixer de NVIDIA ajoute +506 / −74 lignes.
Comme il n’existe pas de panorama de vérité terrain, un essai est jugé par des critères d’acceptation sans référence : recouvrement de profondeur entre vues, recalage temporel par flot optique (temporal warp), rapport de couture au bouclage du panorama (wrap-seam), conservation des contours, et un audit bit à bit qui vérifie que la géométrie verrouillée n’a pas bougé.
Résultats
−27 %
MAE de recouvrement de profondeur entre vues, sur les vues réparées, sans puis avec la synchronisation tenant compte de la profondeur : 0,0340 à 0,0247. Mesuré avant la distillation, sur les pseudo-vues réparées.
0,037→0,020
MAE de recalage temporel par flot optique, rendus bruts contre sortie, sur l’essai de référence de 117 images : 14 vues, 1 638 rendus, environ 20 minutes de temps d’exécution sur un nœud à 4 GPU.
| Ce qui a été mesuré | Valeur | Comment le lire |
|---|---|---|
| MAE de recouvrement de profondeur entre vues des vues réparées, avant distillation, sans puis avec la synchronisation tenant compte de la profondeur | 0,0340 → 0,0247 | Positif, de portée limitée : mesuré sur les vues réparées, pas sur le panorama final. |
| Le même changement après distillation, sur le panorama final : MAE de recalage temporel, premier essai contre la variante profondeur et boucle | 0,0233 contre 0,0258 | Négatif : le gain n’a pas clairement survécu à la distillation. |
| Essai de référence de 117 images : MAE de recalage temporel, rendus bruts vers sortie | 0,037 → 0,020 | Positif, avec une réserve : tout lissage fait baisser cette métrique, elle se lit donc avec la conservation des contours. |
| Même essai : intensité des contours conservée dans les zones à forte confiance (1 = entièrement conservée) | 0,49 en médiane | Une partie de la stabilité vient avec des détails plus flous. |
| Base de référence avant le pipeline : vidéo, COLMAP, Splatfacto, répartition 70/30 | 26,08 dB / 0,91 à 30k, 28,69 dB / 0,94 à 60k | Contexte pour l’étape de reconstruction (PSNR / SSIM). |
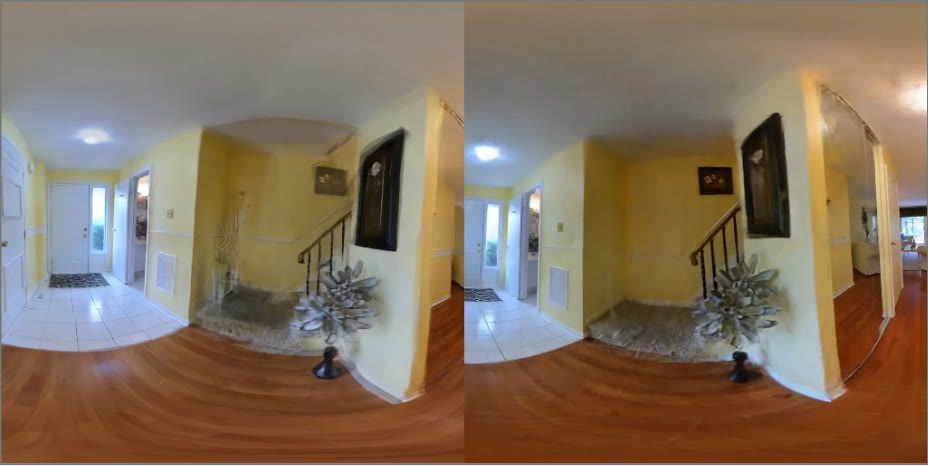
Ce qui a échoué ou reste inachevé
154
images dans l’essai complet à 14 directions. Il a atteint une couverture complète et échoué à mes propres critères d’acceptation visuels et temporels. Ce résultat a mené à une refonte qui part de la géométrie.
Réparer les faces du cube une par une a aggravé les coutures. Le taux d’échec des coutures est passé de 0,34 à 0,83. L’approche a été rejetée après mesure ; le pipeline final répare les 14 vues ensemble.
Le gain de profondeur n’a pas survécu à la distillation. La synchronisation tenant compte de la profondeur améliore l’accord entre les vues réparées, mais la distillation actuelle ne conserve pas ce gain dans le panorama final.
Aucun essai de navigation sur le vrai robot. Sur main, l’inférence de NoMaD n’est pas branchée dans l’interface ROS 2, et aucun essai en boucle fermée sur le Kachaka n’est revendiqué.
La phase 1 reste en simulation. La pose est la vérité terrain du simulateur, la base se déplace de façon cinématique et la scène 3DGS était fournie, pas entraînée là.
Le code d’assemblage de mai inversait les panoramas. Ils sortaient inversés de gauche à droite, comme dans un miroir. Je l’ai trouvé et corrigé en octobre 2026, avec des tests synthétiques et l’aide d’une IA ; la correction est vérifiée contre le moteur de rendu de MuJoCo et des pièces synthétiques, pas confirmée sur un rendu de la scène du laboratoire.
Pas un problème résolu. La méthode ne garantit ni des panoramas sans coutures visibles ni une géométrie correcte. Les preuves se limitent à deux clips d’intérieur et à des métriques sans référence.
Crédits
ArtiFixer-360 est un dérivé de l’ArtiFixer de NVIDIA (nv-tlabs/ArtiFixer, Apache-2.0). Le modèle de diffusion, le code d’inférence de base et 3DGRUT sont le travail de NVIDIA ; mes modifications sont détaillées fichier par fichier dans le dépôt.
La scène 3DGS de la phase 1 a été fournie par le laboratoire. La simulation tourne sur DISCOVERSE et MuJoCo.
Les deux clips d’intérieur derrière les résultats sont des vidéos de tiers que je n’ai pas filmées. Les vidéos elles-mêmes ne sont pas montrées : chaque image de ces pièces sur cette page est un rendu de gaussiennes 3D ou une sortie de modèle qui en dérive. Le dépôt n’indique ni la source ni la licence de ces clips.
Les essais sur GPU ont été faits sur des nœuds à 4 GPU du cluster ABCI.
Assistance par IA : comme déclaré dans l’annexe de mon rapport, des outils d’IA ont servi à la recherche, à l’écriture de code et à la relecture orthographique, pas à lancer les expériences ni à produire les résultats.